TL;DR : ça marche, c’est rapide, et c’est réparable à la main parce que ce n’est que du texte. Mais le projet a un jour d’existence : essayez-le, ne lui confiez pas encore votre mémoire de travail.
Un agent de code oublie tout entre deux sessions. La réponse habituelle est une base de données vectorielle : un serveur de plus, un format qu’on ne lit pas, une facture d’API à chaque recherche. OKF Agent Memory propose l’inverse : la mémoire est un dossier de fichiers Markdown, la recherche un index BM25 en mémoire, et tout vit dans votre dépôt Git. La promesse tient, avec des réserves.
Ce que c’est, exactement
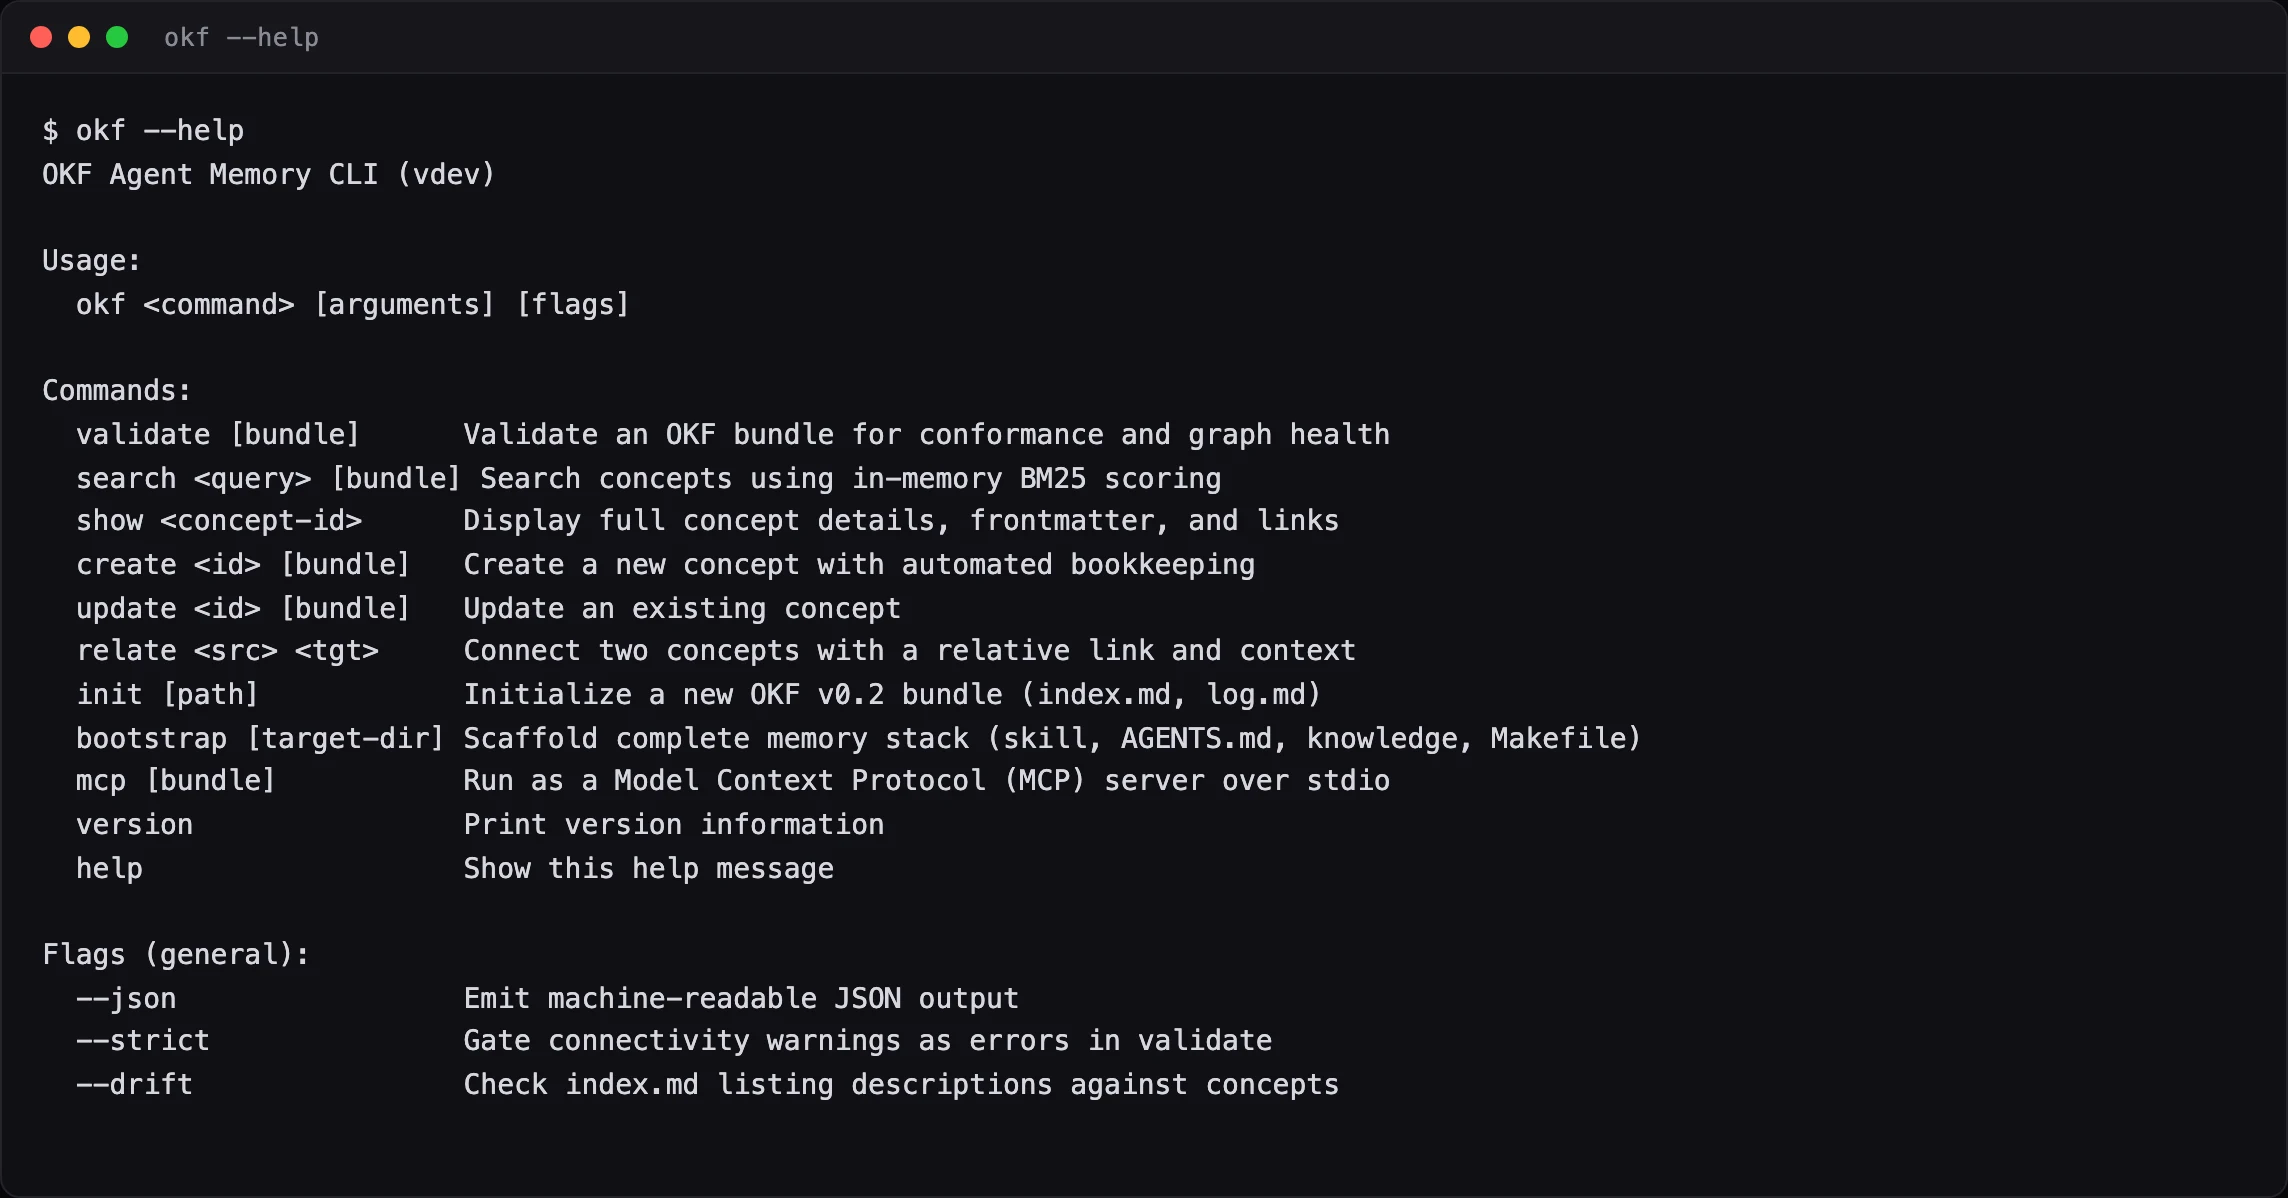
Un binaire en Go, sous licence MIT, qui gère un ensemble de connaissances : des fiches en Markdown à en-tête YAML, un index, un journal, des liens entre fiches. Onze commandes, dont une qui compte : okf mcp, qui en fait un serveur MCP à brancher dans Claude Code, Cursor ou un autre agent.
Le banc d’essai
Premier accroc, et il n’est pas dans la documentation : le projet exige Go 1.22, et se compile mal avec plus ancien. La machine d’essai était en 1.20.4, le make build s’arrête sur une erreur de format de version. Avec une toolchain Go 1.23.4 posée à côté, la compilation prend 3,1 secondes et produit un binaire de 3,5 Mo. Aucune dépendance à télécharger : il n’y a pas de go.sum dans le dépôt, et c’est vrai.
Nous avons initialisé une mémoire, écrit trois fiches réelles (nos propres règles de publication), relié deux d’entre elles, puis ajouté mille fiches synthétiques pour voir ce que ça donne à l’échelle d’un projet de quelques mois.
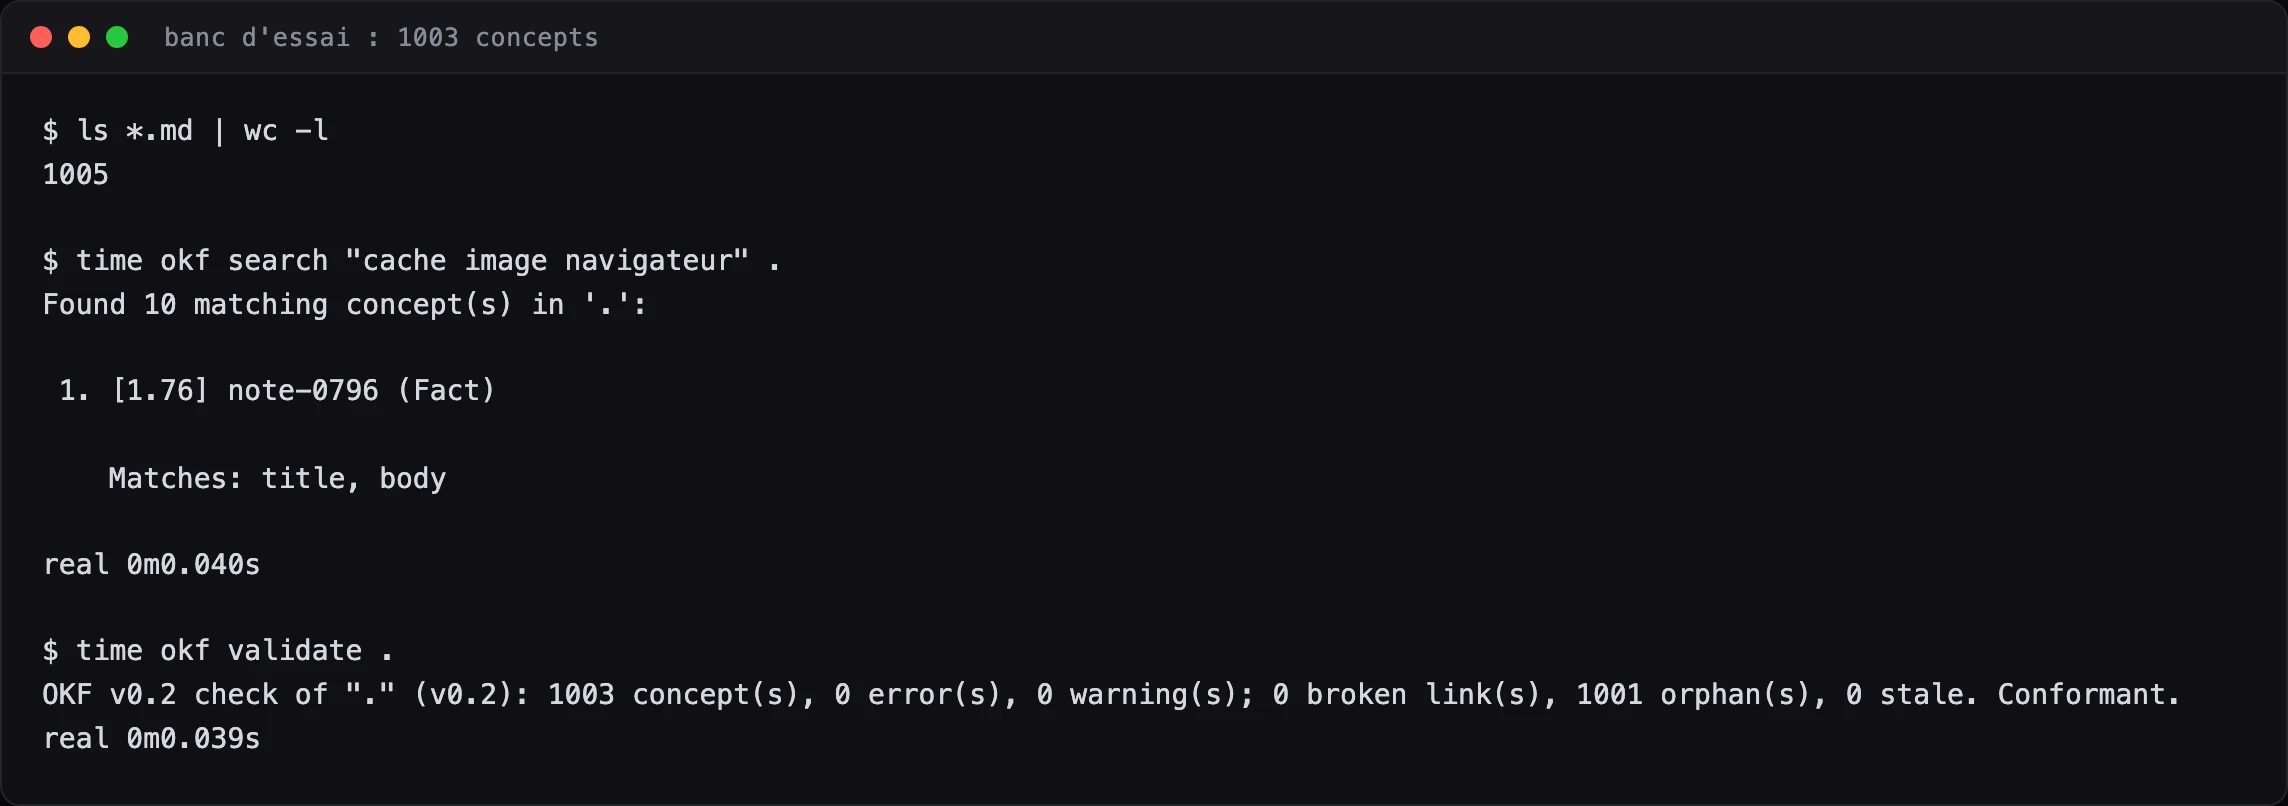
Sur 1 003 fiches, soit 3,9 Mo de Markdown : recherche complète en 40 millisecondes, validation de tout le graphe en 39 millisecondes, 13,9 Mo de mémoire résidente au pic. Ce sont des mesures de bout en bout, démarrage du processus compris, pas les microsecondes internes annoncées par le dépôt. Et la validation ne fait pas que lire : elle signale les liens cassés, les fiches orphelines et les descriptions qui ont dérivé de l’index.
Le serveur MCP, branché à la main
Plutôt que de croire la case « compatible Claude Code », nous avons parlé au serveur en JSON-RPC. Il répond à initialize, annonce six outils (okf_search, okf_show, okf_validate, okf_create, okf_update, okf_relate) et exécute les appels correctement.
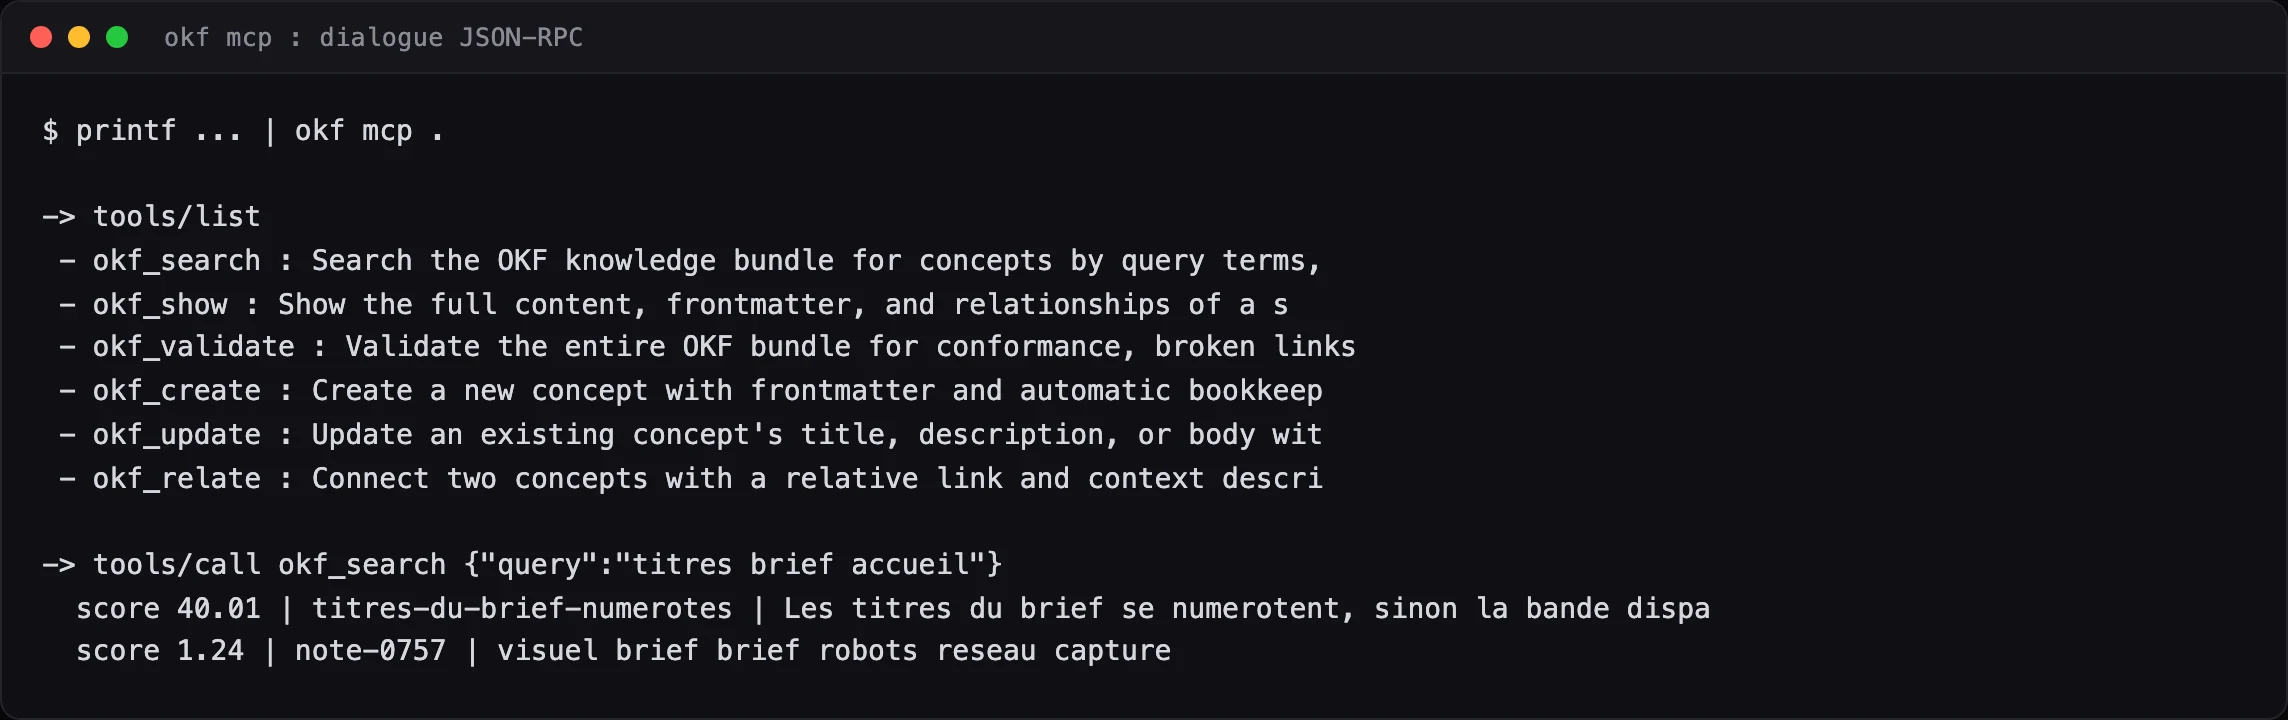
Sur une recherche mêlant nos trois vraies fiches à mille fiches de bruit, la bonne remonte en tête avec un score de 40,01 contre 1,24 pour la première fiche parasite. L’index fait son travail.
Un défaut tout de même : le serveur répond « Method not found » à la notification notifications/initialized, alors qu’une notification JSON-RPC ne doit jamais recevoir de réponse. Sans conséquence ici, mais c’est une entorse à la spécification dans un logiciel dont tout l’intérêt est de se brancher partout.
Ce qu’il pose dans un projet
La commande bootstrap installe l’attirail complet : le dossier de connaissances, un AGENTS.md, un Makefile, et une compétence prête à l’emploi pour l’agent, en six fichiers.
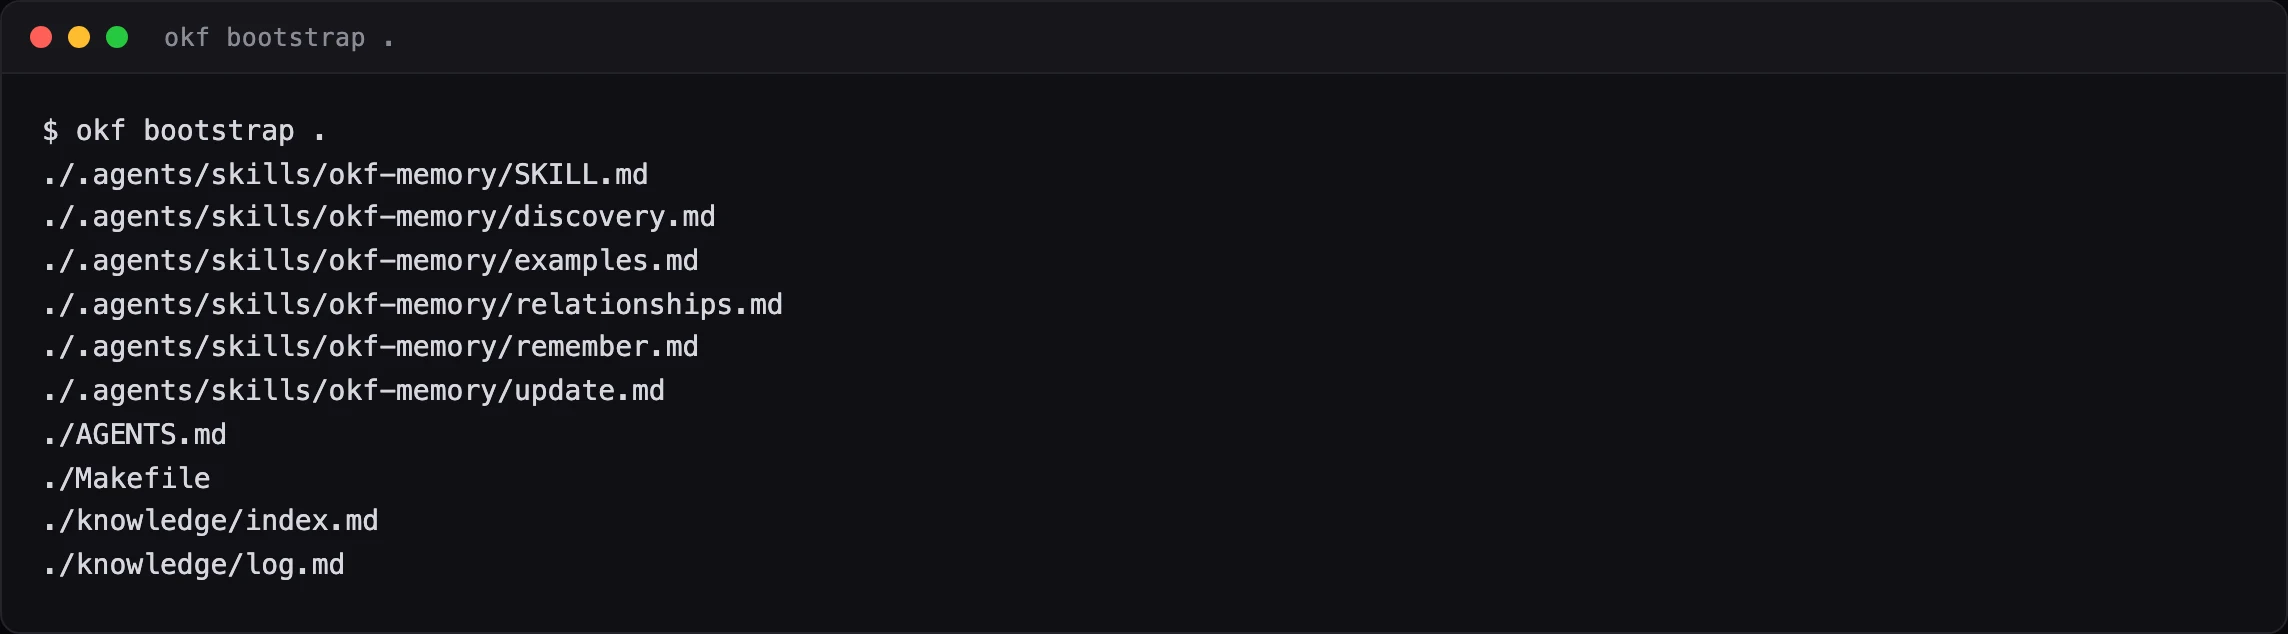
La partie la plus utile et la moins spectaculaire : elle dit à l’agent quand écrire, comment relier deux fiches, et quoi vérifier avant de conclure.
Notre avis
L’idée est juste. Une mémoire qu’on ouvre dans un éditeur, qu’on corrige à la main et qu’on relit dans une pull request vaut mieux qu’un index binaire qu’on ne sait pas inspecter. Et les performances ne sont pas un argument marketing : à mille fiches c’est instantané, et la recherche ne coûte rien puisque rien ne sort de la machine.
La réserve est ailleurs. Ce dépôt portait un seul commit, daté de la veille au soir, quand nous l’avons cloné, et le format qu’il implémente est jeune lui aussi. Rien n’est cassé, mais confier la mémoire d’un projet à un logiciel d’un jour, c’est accepter de la reprendre en main s’il s’arrête. Le bon côté : tout étant du Markdown dans votre dépôt, votre mémoire vous reste même si l’outil disparaît. C’est l’argument de ses auteurs, et c’est le meilleur.
Le dépôt est ici.