Notre calculateur d’IA locale répond en gigaoctets et refuse de nommer un modèle. llmfit fait l’inverse : il en nomme 8 410, classés, avec une vitesse estimée pour chacun. Nous l’avons fait tourner sur la même machine, et la comparaison dit surtout ce qu’un catalogue tiré de Hugging Face charrie avec lui.
C’est Cyril qui a déposé le lien, avec cette question : est-ce notre
calculateur en plus gros ? llmfit
est sous licence MIT, affiche 36,6 mille étoiles, et s’installe par brew install llmfit
ou cargo install llmfit. Nous avons pris le binaire Apple Silicon de la version
1.1.15, publiée le 10 septembre, empreinte vérifiée : 6,1 Mo, un seul fichier.
Ce qu’il lit sur la machine
llmfit system répond en une seconde : Apple M1 Max, 10 cœurs, 64 Go, moteur Metal, et
deux chiffres que notre outil ne sait pas produire. Une bande passante mémoire mesurée,
entre 235 et 257 Go/s selon les passes, et 51,84 Go réellement disponibles pour le
calcul sur les 64 partagés.
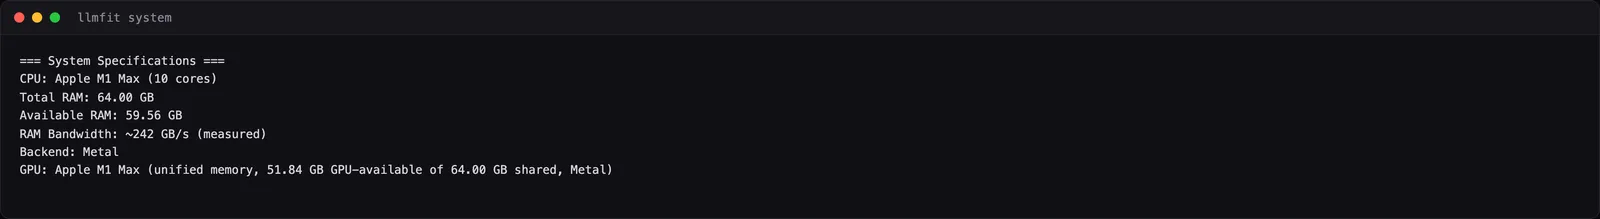
Ce second chiffre est ce que notre calculateur estime à la louche, par sa règle des trois quarts moins deux gigaoctets : 46 Go chez nous, 51,84 mesurés chez lui. L’écart est celui qu’on attend entre une règle de pouce dans un navigateur et un programme qui interroge le système.
8 410 modèles en 2,5 secondes, sans réseau
llmfit fit rend son tableau en 2,5 secondes. Nous avons recommencé derrière un
mandataire volontairement injoignable : même résultat, même durée. Le catalogue est dans le
binaire, et c’est llmfit update qui va chercher les nouveautés sur Hugging Face, dans un
fichier de cache à part.
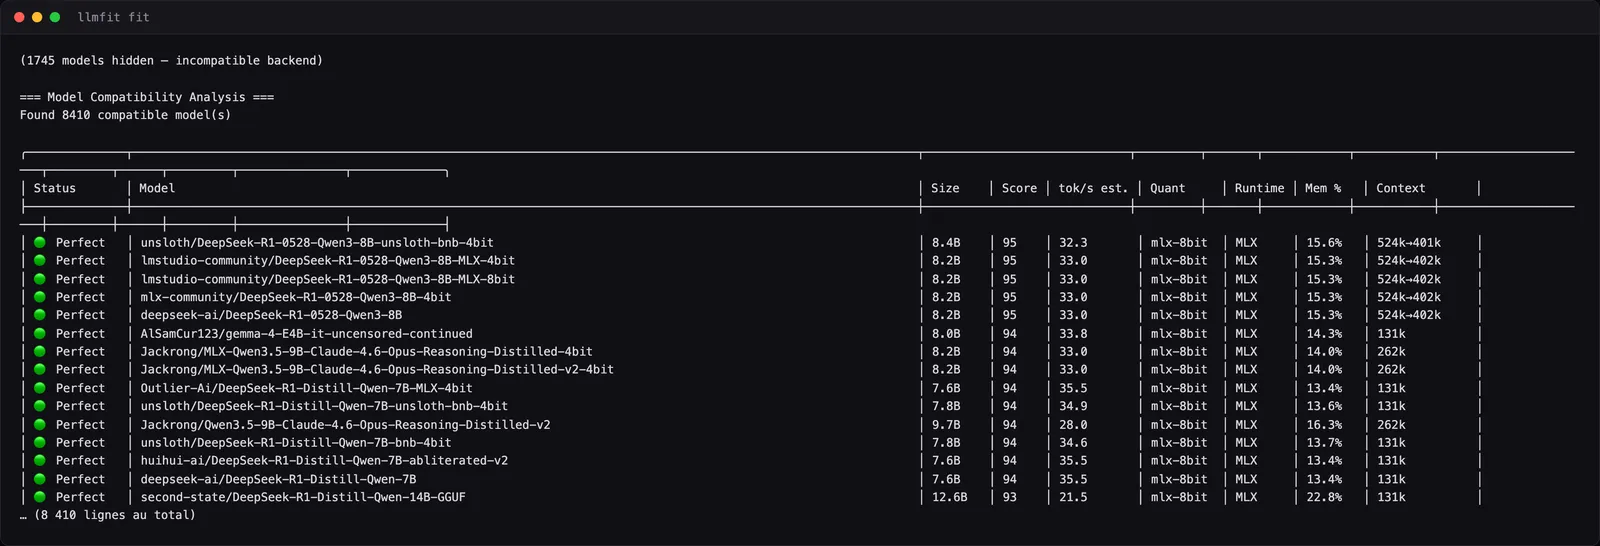
Le catalogue compte 12 160 entrées. Sur notre Mac, 8 410 sont déclarées compatibles, 1 745 masquées pour moteur incompatible, et 7 243 portent la mention « Perfect ». Quand 86 % des réponses sont parfaites, le mot ne trie plus rien.
Et le haut du tableau surprend sur une machine à 64 Go : les quinze premiers sont des modèles de 8 milliards de paramètres, variantes du même DeepSeek distillé, notés 95. Le score mélange place, qualité et vitesse, et la vitesse gagne. Les gros modèles sont plus bas, jusqu’à 54 Go, à 5 à 9 jetons par seconde estimés.
Ce que le catalogue charrie
C’est là que la comparaison devient intéressante. Notre calculateur ne nomme rien, par principe : un nom de modèle est faux dans trois mois. llmfit nomme tout, et « tout » vient de Hugging Face tel quel.
Dans les 12 160 entrées : 1 198 modèles de synthèse vocale (le premier de la liste est un modèle texte-parole pour une langue de Nouvelle-Guinée), 469 variantes estampillées abliterated, uncensored ou heretic, 164 noms qui revendiquent une distillation de Claude, et 2 698 entrées sans licence renseignée. Les tailles sont parfois fausses : un « Qwen3.8-27B » compté à 7,7 milliards, un « gemma-4-12B » à 3,4 milliards, et une colonne de quantification qui dit « mlx-8bit » sur des fichiers dont le nom dit « 4bit ».
Rien de tout cela n’est un mensonge du logiciel : c’est l’état des fiches sur Hugging Face.
Mais qui tape llmfit fit et prend la première ligne ne le sait pas.
Le banc contre Ollama, et ses limites
llmfit voit Ollama sur la machine. Sur nos neuf modèles installés, il en a relié un seul
à son catalogue, et en a déclaré un second installé qui ne l’est pas. Notre gemma4:12b
n’a pas d’entrée chez lui : le catalogue connaît Gemma 4 en 26, 31, E2 et E4 milliards, pas
en 12.
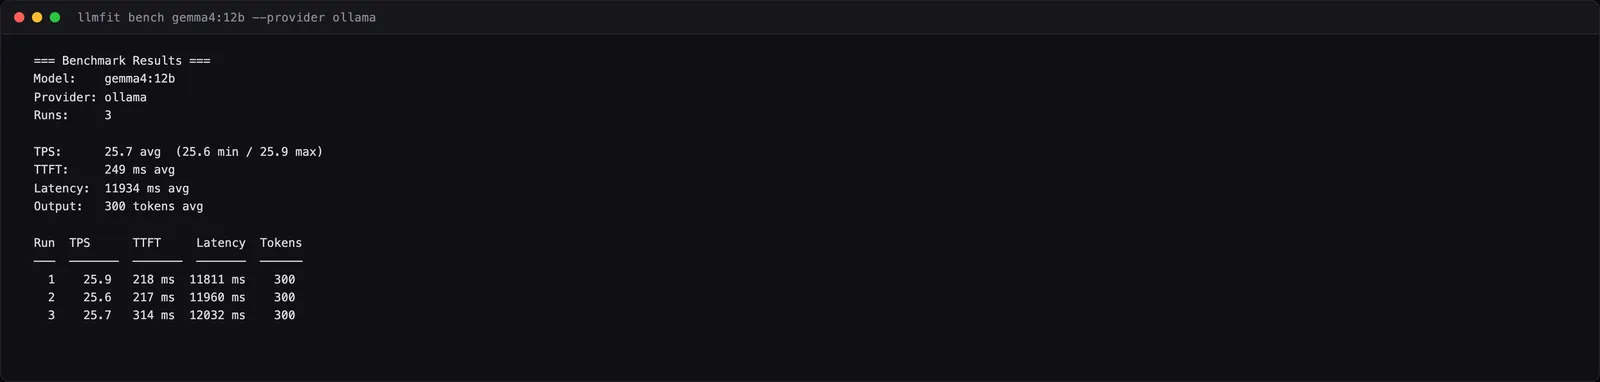
Son banc, lui, fonctionne bien : 25,7 jetons par seconde sur gemma4:12b, premier
jeton en 249 millisecondes, trois passes serrées entre 25,6 et 25,9. Et 46,0 sur
qwen3.6, qui est chez Ollama un modèle de 36 milliards à experts mélangés. Aucune des deux
mesures n’a pu être comparée à une estimation, faute d’entrée correspondante : l’outil
mesure d’un côté, estime de l’autre, et ne se corrige pas lui-même sur nos modèles. Les
résultats restent en local, et ne partent au projet que si vous tapez --share.
Une réserve de méthode, à nous : le troisième banc, sur le seul modèle reconnu, a chargé 58 Go et pris tout le processeur graphique, et nous l’avons arrêté avant la fin. C’est ce que fait un banc, pas un défaut de llmfit.
Notre avis, et ce que ça change au Labo
Si vous avez la ligne de commande, prenez-le : la détection matérielle vaut le téléchargement, et le banc contre Ollama est le geste qui manque à tout le monde. Lisez le tableau comme un annuaire, pas comme un verdict, et regardez la licence avant le score.
Face à notre calculateur, les deux outils ne répondent pas à la même question. Le nôtre dit combien de gigaoctets vous avez devant vous, et reste vrai dans deux ans. llmfit dit lequel, aujourd’hui, avec le bruit du catalogue. Ce qu’il fait mieux, et que nous ne faisons pas du tout, c’est la vitesse : sa formule est publique, la bande passante mémoire divisée par la taille du modèle, avec un coefficient. Notre outil connaît la famille de puce, pas sa bande passante. C’est un manque précis, et c’est le prochain chantier.