TL;DR : pour chercher dans des documents en français sans rien envoyer à personne, EmbeddingGemma 2 tient sur n’importe quel ordinateur récent, va vite même sans carte graphique, et trouve ce que les mots-clés ratent. Mais en texte, il ne fait guère mieux que sa première version : passez-y pour la licence Apache 2.0, les images et le contexte quatre fois plus long, pas pour un bond de justesse. Gardez 512 dimensions, pas moins, et réglez le seuil du « rien trouvé » sur vos propres documents.
Un embedding, en une recherche
Un modèle d’embeddings ne rédige rien. Il transforme un texte en une liste de nombres, un vecteur, de sorte que deux textes qui disent la même chose tombent près l’un de l’autre, même sans un mot en commun. C’est la pièce qui permet de chercher par le sens, et le premier étage de tout RAG, ces assistants qui répondent à partir de vos documents : avant de rédiger, il faut retrouver les bons passages.
Un exemple tiré de notre banc. La question « Comment repérer une étude de recherche copiée puis reformulée par un logiciel ? » ne partage aucun mot important avec le titre de notre article sur les « tortured phrases », qui parle de « mots absurdes » et de « faux article scientifique ». Une recherche par mots-clés classe cet article 48e. EmbeddingGemma 2 le met en premier.
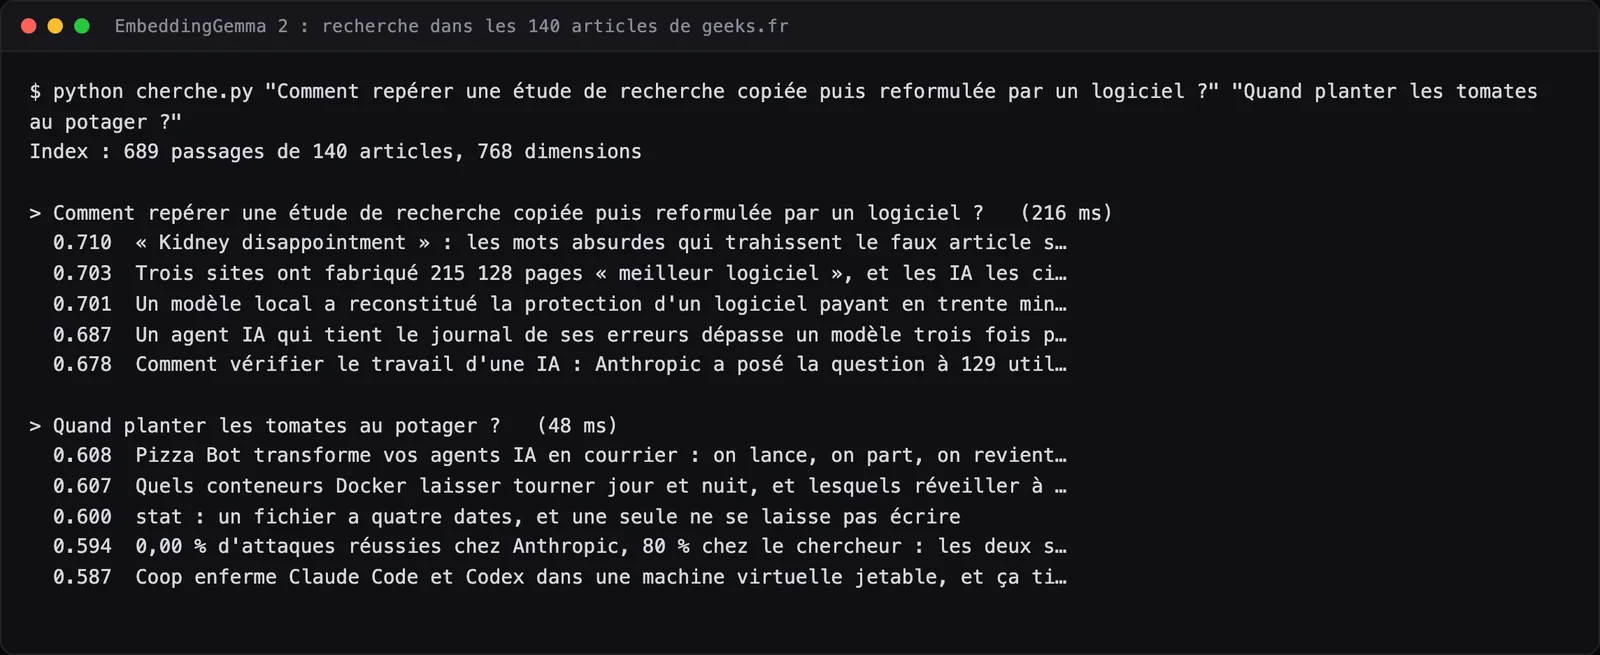
Regardez les scores : le premier n’a que sept millièmes d’avance sur le deuxième, et la question sur les tomates, sans aucune réponse chez nous, obtient quand même 0,608. Retenez ces deux chiffres, ils comptent plus loin.
Ce que Google annonce
Google a publié EmbeddingGemma 2 le 6 octobre. Ce qui change depuis la première version, de septembre 2025 :
- La licence : Apache 2.0, avec un téléchargement libre sur Hugging Face. La première version était sous licence Gemma, et il fallait accepter des conditions pour la récupérer.
- Les modalités : texte, code, images, vidéo et audio dans un même espace. Un seul modèle se charge en quatre tailles selon ce qu’on active : 270 millions de paramètres en texte seul, 440 avec la vision, 570 avec l’audio, 740 avec tout.
- Le contexte : 8 192 jetons, quatre fois plus qu’avant. Une dizaine de pages tient d’un bloc.
- Des vecteurs qu’on raccourcit : 768 nombres par passage, ou seulement les 512, 256 ou 128 premiers. Google donne l’exemple d’un million de vecteurs : 1,5 Go en 768 dimensions, 250 Mo en 128.
Ce que la fiche du modèle dit moins fort : en texte, le progrès est minime. Sur le banc MTEB multilingue, EmbeddingGemma 2 obtient 61,36, contre 61,15 pour la première version. Le vrai bond est sur le code (78,68 contre 68,76) et sur tout ce que la première version ne savait pas faire. Le français n’est jamais cité nommément (« plus de 100 langues »), et la documentation française de Google décrit encore la première version.
Notre banc, en français
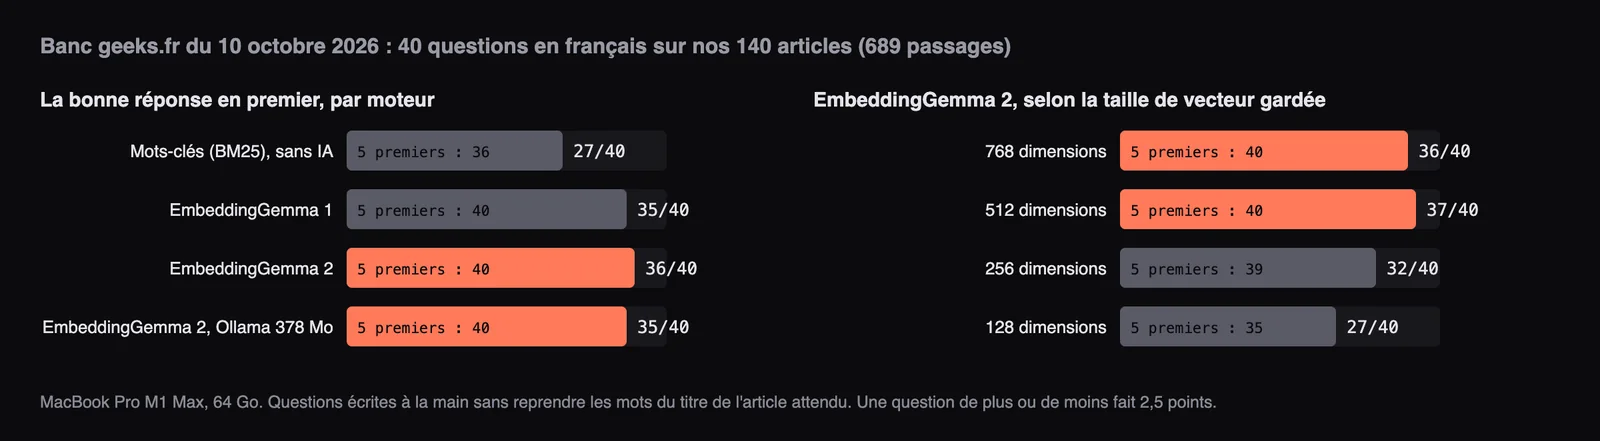
Le modèle a tourné le 10 octobre sur notre MacBook Pro M1 Max de 64 Go. Le corpus : les 140 articles de geeks.fr, découpés en 689 passages, soit 92 114 mots. Les questions : 40, écrites à la main avant le premier calcul, sans reprendre les mots du titre de l’article attendu, plus 10 questions sans aucune réponse chez nous (une recette, un pneu crevé, un réglage de WireGuard), pour vérifier que le moteur sait se taire. Face à lui : une recherche par mots-clés classique (BM25, ce que fait un moteur interne ordinaire) et la première EmbeddingGemma.
Les limites, dites d’entrée : un seul corpus, technique, et 40 questions. Une bonne réponse de plus ou de moins fait 2,5 points : les écarts d’une ou deux questions ne prouvent rien.
| Moteur | Bonne réponse en premier | Dans les cinq premiers |
|---|---|---|
| Mots-clés (BM25) | 27 sur 40 | 36 sur 40 |
| EmbeddingGemma 1 | 35 sur 40 | 40 sur 40 |
| EmbeddingGemma 2 | 36 sur 40 | 40 sur 40 |
| EmbeddingGemma 2 par Ollama, version de 378 Mo | 35 sur 40 | 40 sur 40 |
Le saut est entre les mots-clés et le sens, pas entre les deux versions. Neuf bonnes réponses de plus en passant à un modèle d’embeddings, une seule de plus en passant à la nouvelle version. C’est exactement ce que disaient les chiffres de Google, et c’est rassurant sur leur honnêteté. La version allégée d’Ollama, d’un tiers plus légère que sa version texte complète, ne perd qu’une question.
Savoir dire « je n’ai rien trouvé »
C’est le point qui compte le plus pour un moteur interne, et le contrôle négatif le mesure. Chez EmbeddingGemma 2, le premier résultat d’une vraie question obtient un score médian de 0,771 ; celui d’une question sans réponse, 0,674 ; la pire des fausses pistes monte à 0,736. Placé juste au-dessus de ce 0,736, un seuil laisserait passer 33 des 36 bonnes réponses, contre 29 pour la première version et 16 pour les mots-clés.
La nouvelle version sépare donc mieux le vrai du vide. Mais tout se joue dans un mouchoir de poche : entre 0,67 et 0,77. Un score n’a aucun sens dans l’absolu, il se calibre sur vos documents, avec vos questions sans réponse. Un moteur interne réglé à l’aveugle affichera toujours un « meilleur résultat », y compris quand il n’y en a pas.
Raccourcir les vecteurs : 512, pas moins
| Taille gardée | Place d’un vecteur | En premier | Dans les cinq premiers |
|---|---|---|---|
| 768 dimensions | 3 072 octets | 36 sur 40 | 40 sur 40 |
| 512 dimensions | 2 048 octets | 37 sur 40 | 40 sur 40 |
| 256 dimensions | 1 024 octets | 32 sur 40 | 39 sur 40 |
| 128 dimensions | 512 octets | 27 sur 40 | 35 sur 40 |
Google annonce une perte « presque nulle » jusqu’à 256 dimensions. Sur nos articles en français, 512 ne coûte rien, 256 coûte déjà quatre bonnes réponses, et 128 ramène au niveau des mots-clés. Si la place compte, gardez 512 dimensions : un tiers de place en moins, sans perte mesurée sur notre corpus.
Vitesse, mémoire, énergie
| Configuration | Indexer 92 114 mots | Une question | Mémoire |
|---|---|---|---|
| Carte graphique, float32 | 24 s (21,6 à 25,8 sur trois passes) | 34 ms | 2,4 Go pour le processus |
| Carte graphique, bfloat16 | 30 s (29,1 à 30,6) | 40 ms | 1,3 Go |
| Processeur seul, float32 | 71 s | 71 ms | 5,0 Go |
| Ollama, version de 378 Mo | 25 s | 22 ms | 346 Mo |
| Ollama, version bfloat16 | 21 s | 20 ms | 542 Mo |
Trois enseignements. Le processeur seul suffit : trois fois plus lent, mais 71 secondes pour
tout notre site, et des vecteurs strictement identiques à ceux de la carte graphique. Le
bfloat16 conseillé par Google est plus lent sur un M1 : la puce ne le calcule pas nativement,
comme nous l’avions mesuré avec Qwen-Image.
Le float16, plus rapide sur Mac, est proscrit par la fiche : le modèle y rend des valeurs vides
ou dégradées. Ollama est le plus simple et le plus économe en mémoire. Un piège au passage :
son réglage pour forcer le processeur seul est ignoré par son moteur MLX sur Mac, qui reste sur
la carte graphique. Sa page annonce aussi 256 000 jetons de contexte ; ollama ps affiche bien
les 8 192 de Google.
L’énergie, mesurée par macmon sur la machine entière : 0,7 Wh pour mille passages sur la carte graphique, 1,3 Wh sur le processeur seul. Indexer tout geeks.fr coûte donc moins d’un demi-wattheure, à peu près ce que coûte un seul courriel écrit par un gros modèle local dans notre mesure de septembre.
Retrouver une photo avec une phrase
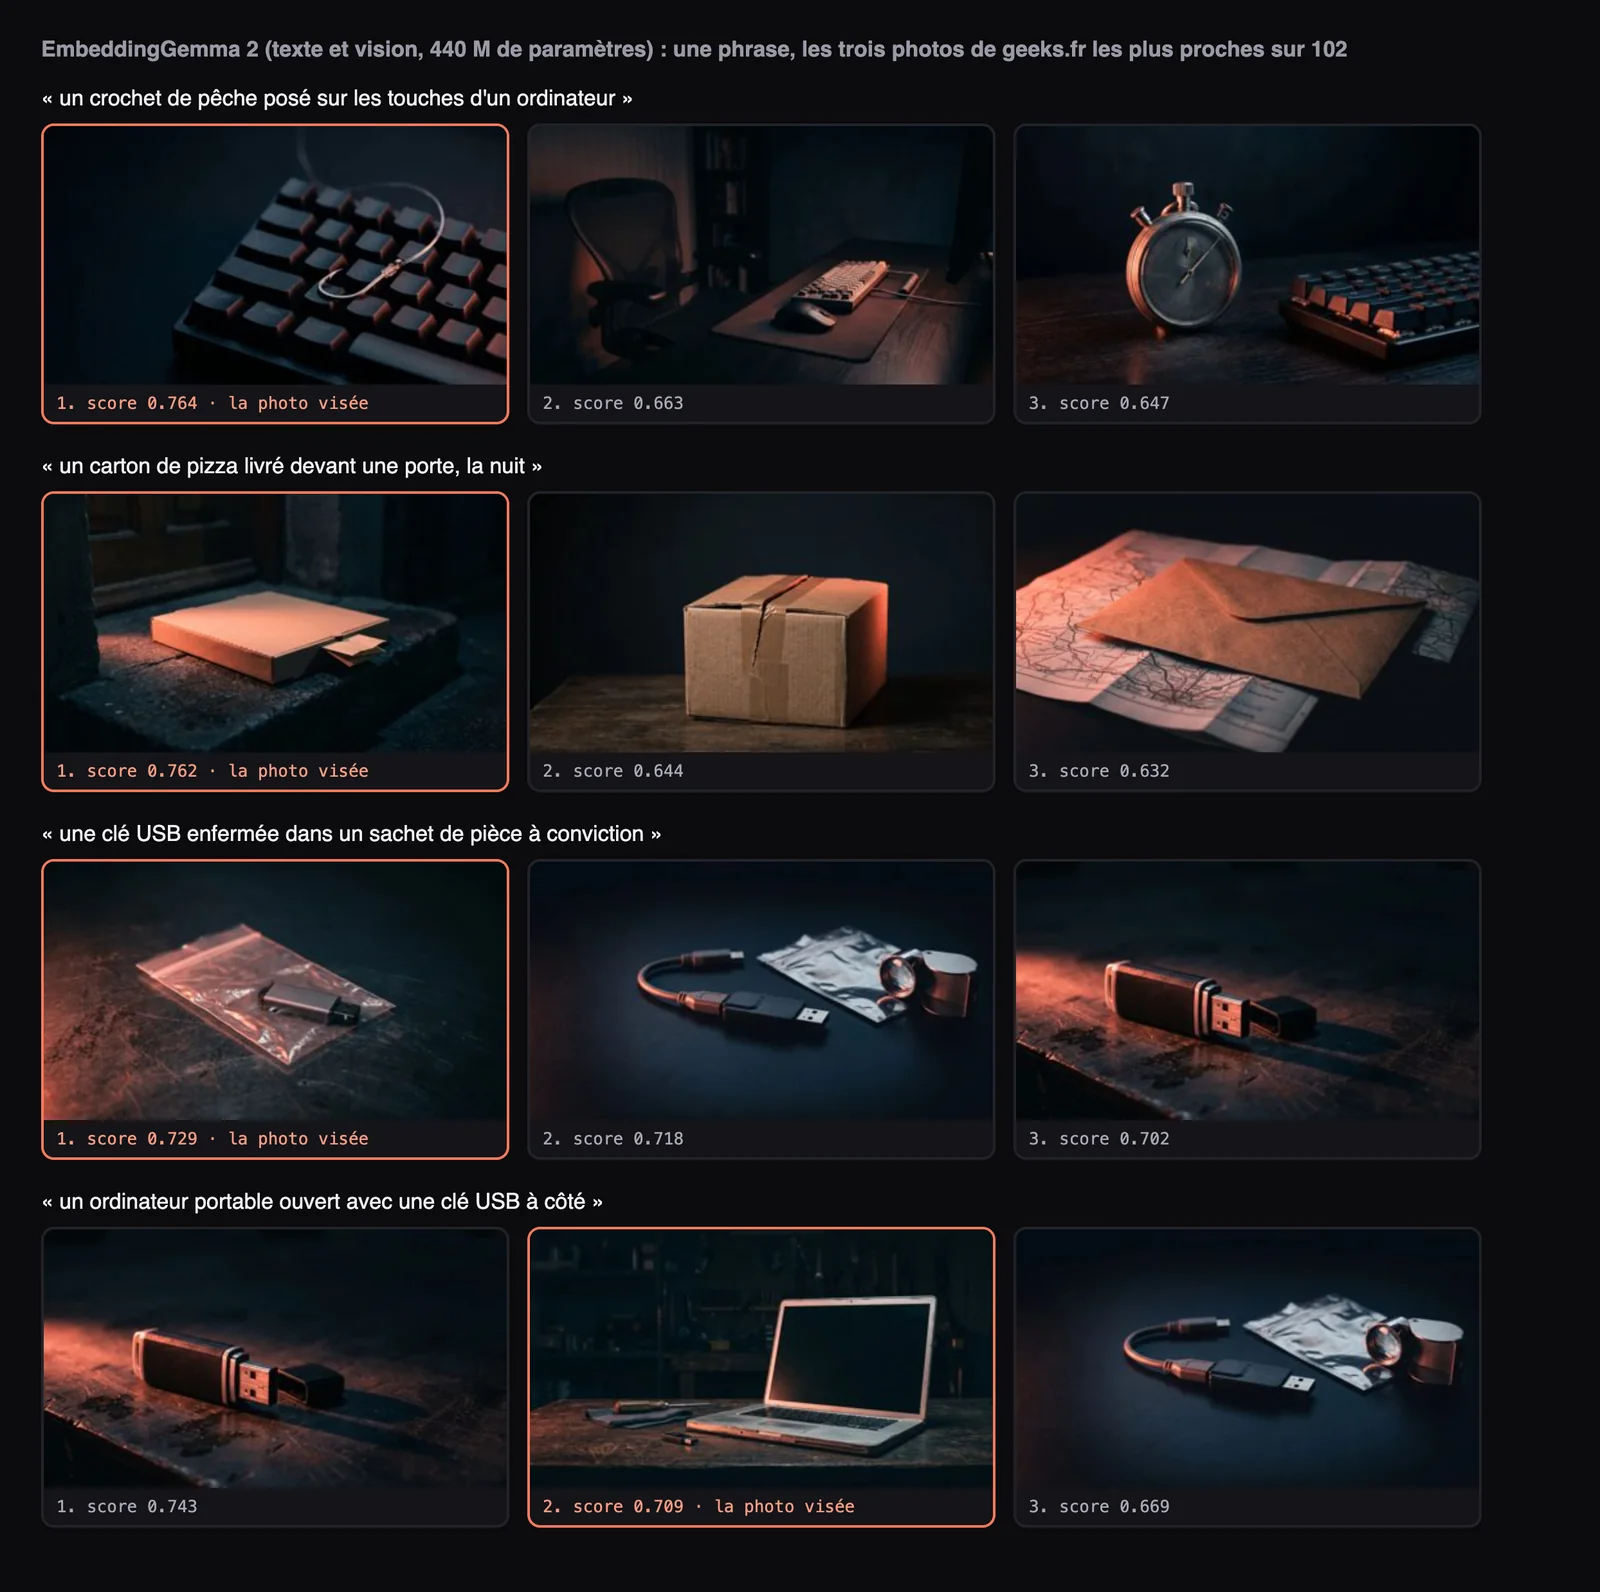
Nous avons chargé la version texte et vision (440 millions de paramètres) et lui avons donné nos 102 photos de une, qui ont toutes le même style : un objet dans le noir, une lumière corail. Une phrase en français, et la photo visée doit sortir en tête. 20 sur 20 sur des objets distincts (un hameçon sur un clavier, une boîte à pizza sur un seuil), puis 8 sur 10 sur une série difficile où chaque photo a des sosies : plusieurs interrupteurs en bakélite, six boîtes à fiches, deux clés USB. Les deux ratés sont arrivés deuxième et troisième. Aucune des cinq phrases sans image correspondante (un chat, un vélo) n’a dépassé une vraie réponse.
Le calcul est plus lourd que pour le texte : 0,34 à 0,37 seconde par image sur la carte graphique. Une photothèque de 10 000 images s’indexe en une heure, une fois pour toutes.
En entreprise : pour quoi faire
Ce que ce modèle sait faire, et qu’une entreprise peut brancher dès maintenant :
- Un moteur de recherche interne sur la documentation, les procédures, le wiki : il trouve le bon document quand l’employé n’emploie pas le vocabulaire de celui qui l’a écrit. À condition de régler le seuil du « rien trouvé », comme vu plus haut.
- Le premier étage d’un assistant sur vos documents. EmbeddingGemma 2 retrouve les passages ; il faut un autre modèle, local lui aussi si les données ne doivent pas sortir, pour rédiger la réponse. Google pense à Gemma 4.
- Trier et regrouper : dédoublonner des tickets, classer des courriels entrants, regrouper des avis clients. Le modèle a des préfixes prévus pour la classification et le regroupement.
- Chercher dans ce qui n’est pas du texte : une photothèque, des documents scannés, des diapositives, et selon Google des enregistrements de réunion de cinq minutes et demie au plus par morceau. Nous n’avons testé que les images.
- Chercher dans du code, là où Google annonce son plus gros progrès. Non testé ici.
Pourquoi le local compte : un texte transformé en vecteur chez un prestataire est un texte envoyé chez ce prestataire. Ici, rien ne sort de la machine, ce qui règle la question du RGPD et du secret des affaires pour cet étage-là. La licence Apache 2.0 autorise l’usage commercial. Une réserve à soumettre à votre juriste : la fiche du modèle demande quand même de respecter la « Gemma Prohibited Use Policy », une liste d’usages interdits que la licence Apache, elle, ne contient pas. Et la fiche précise que le modèle n’a reçu aucun réglage de sécurité après son entraînement : les garde-fous sont à la charge de qui le déploie.
Sur quoi le faire tourner
D’après nos mesures, n’importe quel ordinateur récent suffit, carte graphique ou non, et un serveur sans carte fait l’affaire pour indexer de nuit. D’après celles de Google, sur leurs appareils et que nous n’avons pas pu refaire : environ 190 Mo de mémoire en texte seul sur un téléphone Pixel 11 Pro, 161 millisecondes par texte sur un Raspberry Pi 5, et une version pour le navigateur (transformers.js, 473 Mo en 4 bits) qui tourne sans rien installer.
La vraie question d’une entreprise n’est pas la puissance de calcul, c’est la place et le temps pour tout indexer. L’outil ci-dessous les calcule sur nos mesures :
Labo Combien de place et de temps pour indexer vos documents
Place des vecteurs
—
Durée d'indexation
—
Énergie de la machine
—
Débits et énergie mesurés par geeks.fr le 10 octobre 2026 avec EmbeddingGemma 2 en texte seul, sur des passages d'environ 135 mots. La place ne compte que les vecteurs : le texte, les métadonnées et l'index de recherche s'y ajoutent.
Pour ranger ensuite ces vecteurs et y chercher vite, un index vectoriel fait l’affaire : turbovec, que nous avons testé en août, tient des millions de vecteurs compressés sur une seule machine.
S’y mettre en trois commandes
Avec Ollama, la version texte de 378 Mo :
ollama pull embeddinggemma-2:270m
curl http://localhost:11434/api/embed -d '{"model": "embeddinggemma-2:270m", "input": "task: search result | query: comment résilier mon contrat ?"}'
⚠️ Ollama n’ajoute pas les préfixes que le modèle attend : task: search result | query:
devant une question, title: <le titre> | text: devant un document. Sans eux, ça marche
encore, moins bien. En Python, sentence-transformers 6.1 les pose pour vous :
from sentence_transformers import SentenceTransformer

modele = SentenceTransformer(
    "google/embeddinggemma-2",
    config_kwargs={"vision_config": None, "audio_config": None},  # texte seul, 270 M
)
docs = modele.encode([f"title: {t} | text: {x}" for t, x in mes_documents], normalize_embeddings=True)
question = modele.encode("comment résilier mon contrat ?", prompt_name="SearchQuery", normalize_embeddings=True)
scores = modele.similarity(question, docs)
Le tutoriel d’affinage de Google, pour spécialiser le modèle sur son vocabulaire, existe aussi. Il tient sur trois exemples : de quoi comprendre la mécanique, pas de quoi juger le résultat. Commencez par mesurer sur vos documents, avec vos questions et vos questions sans réponse : c’est une heure de travail, et c’est elle qui vous dira si vous avez besoin d’aller plus loin.